Kompression als Via Negativa: Das günstigste Token ist das, das Sie nie verschicken
Nehmen Sie eine beliebige Session mit einem Coding-Agent und öffnen Sie das rohe Request-Log. Nicht das hübsche Protokoll - die tatsächliche Payload. Was Sie finden: ein JSON-Suchergebnis mit 100 Treffern, von denen 3 relevant waren. Eine Log-Datei, in der die entscheidende Zeile unter 800 Zeilen "INFO: still fine" begraben liegt. Und ein Verzeichnislisting eines Repos, das das Modell bereits zweimal durchlaufen hat.
Dann stellen Sie das unbequeme Verhältnis auf: Kosten des fertigen Outputs versus die Menge an Input, die tatsächlich nötig gewesen wäre. Das Modell brauchte vielleicht 2.000 Token echtes Signal. Bezahlt haben Sie 55.000. In der Fertigung wäre das ein Bauteil aus massivem Gold, nur um eine Plastikklemme zu halten.
Ich habe ein paar Wochen lang alles - Coding, Recherche, stumpfe Textarbeit - durch einen Komprimierungs-Proxy namens Headroom geschickt. Das Interessante war nicht das Geld. Es war die Erkenntnis, wie viel von dem, was ich dem Modell "gesendet" habe, nie Information war.
Was das Tool konkret macht
Es sitzt zwischen Ihrem Agent und der API und komprimiert alles, was das Modell liest - Tool-Outputs, Logs, abgerufene Chunks, Gesprächsverläufe - bevor es weitergeleitet wird. Die Kompression passiert lokal, nichts wird an Dritte geschickt. Das Modell kann bei Bedarf auf das Original zugreifen.
Es gibt eine Fan-Theorie zu Rick and Morty, die mehr Management-Bücher überlebt hat als jedes Regal fassen kann: Wer sich für Rick hält, ist bereits Jerry.
Kurzes Briefing für die drei Menschen, die die Serie nicht kennen: Rick ist das verrückte Genie, das aus einem Toaster eine Portal-Pistole baut und sich nichts sagen lässt. Jerry ist sein Schwiegersohn - gutmütig, unsicher, arbeitslos, permanent auf Bestätigung angewiesen und felsenfest überzeugt, dass sein Beitrag unterschätzt wird. Beth, Ricks Tochter, ist Chirurgin. Sie operiert Pferde. Was ich angesichts meines üblichen Vokabulars als kosmische Bestätigung werte. 🐎
In jeder Technik-Organisation, in der ich gearbeitet habe, war das Rick-zu-Jerry-Verhältnis exakt umgekehrt zur Selbsteinschätzung. So ziemlich jeder im Raum war überzeugt, die eine Person zu sein, die den Laden zusammenhält. Die tatsächlich tragende Säule war meistens still, leicht zerknautscht und gar nicht im Meeting - weil irgendjemand ja die Produktion am Laufen halten musste.
Das Verhältnis
In einem Unternehmen haben wir vor einer Umstrukturierung eine interne Kompetenz-Selbsteinschätzung durchgeführt. Klassisches Unternehmensritual: Bewerten Sie sich von 1 bis 5 in verschiedenen Kategorien. Rund 70 Prozent der technischen Belegschaft stuften sich beim Debugging komplexer Probleme über dem Teamdurchschnitt ein.
Mathematisch unmöglich, selbstverständlich. Aber das war nicht der interessante Teil.
Der interessante Teil: Wir hatten auch vier Jahre Incident-Daten. Wer tatsächlich die Eskalationen gelöst hatte, an denen alle anderen gescheitert waren. Und die Korrelation zwischen Selbsteinschätzung und tatsächlicher Lösungsbilanz war nicht nur schwach. Sie war leicht negativ.
Drei Wörter, die offenlegen, wie wenig wir die Maschinen verstehen, von denen wir inzwischen abhängen
Der komischste Prompt der modernen Informatik ist drei Wörter lang. Und er steht in Produktivsystemen von Unternehmen, die echten Umsatz machen.
"Mach keine Fehler."
Manchmal mit Nachdruck. MACH KEINE FEHLER. Manchmal mit einer Drohung garniert, als hätte das Modell eine Familie. Manchmal mit dem Versprechen eines Trinkgelds - mein persönliches Lieblingsgenre des magischen Denkens: eine Wahrscheinlichkeitsverteilung bestechen.
Bleiben Sie kurz bei der Grundannahme. Einem System zu sagen, es solle keine Fehler machen, unterstellt, dass es sich vorher aktiv für Fehler entschieden hat. Das hieße, eine von drei Sachen muss stimmen: Es wurde darauf trainiert, Fehler zu machen. Es wurde angewiesen, Fehler zu machen (vielleicht von einem Dienstleister, der pro Token abrechnet - eine herrlich paranoide Theorie, die sofort stirbt, sobald man feststellt, dass offene Modelle sich genauso verhalten). Oder Fehler sind ein Feature, das standardmäßig aktiviert ausgeliefert wird.
Nichts davon überlebt zehn Sekunden Konfrontation mit der tatsächlichen Funktionsweise. Ein Sprachmodell hat keinen Faulheitsregler. Es hat nicht die Absicht, schlampig zu sein, weil es überhaupt keine Absichten hat. Es erzeugt die statistisch plausible Fortsetzung Ihres Textes. "Mach keine Fehler" ist keine Anweisung. Es ist eine Stimmung. Es verschiebt die Ausgabe ein Stück in Richtung jener Texte, die in den Trainingsdaten neben sorgfältigem, abgesichertem, autoritär klingendem Sprachgebrauch stehen. Deshalb klingt die Antwort danach oft selbstbewusster - und ist dabei genauso falsch wie vorher. Sie haben nicht die Fehlerquote gesenkt. Sie haben die Verpackung aufgewertet.
Das Internet hat dieses Experiment schon einmal durchgeführt. Wir wollten das Ergebnis nur nicht wahrhaben.
Erinnern Sie sich noch an Einwahlmodems? Man bezahlte pro Minute für den Zugang zum gesammelten Wissen der Menschheit - und nutzte diese kostbaren Minuten, um ein 400x300-Pixel-JPEG einer Katze in einem Schuhkarton herunterzuladen.
Dann fiel der Minutentakt weg. Flatrate. Dann Mobilfunk. Dann kostenloses WLAN in der durchschnittlichen Bäckerei. Plötzlich hatte jeder Mensch auf dem Planeten ein Portal zu jeder Bibliothek, jeder Vorlesung, jedem Tutorial, jeder jemals dokumentierten Fachkompetenz. Universitäten stellten ihre kompletten Lehrpläne kostenlos ins Netz. Das MIT machte es. Harvard machte es. Niemand musste mehr um Erlaubnis fragen.
Und was passierte?
TikTok passierte. Instagram passierte. LinkedIn passierte - im Grunde Instagram für Leute, die ein Sakko besitzen. Auf YouTube existieren Millionen von Lehrvideos, und die meistgesehenen Inhalte sind Menschen, die darauf reagieren, wie andere Menschen auf Videospiele reagieren.
Das ist kein Lamento. Ich mag Katzenbilder. Ich habe 22 Minuten lang einem Mann zugesehen, wie er eine verrostete Axt restaurierte und danach echten inneren Frieden gespürt. Die Beobachtung ist nüchterner als jedes Urteil: Unbegrenzter Zugang zu Wissen hat Ergebnisse nicht umverteilt. Die Menschen, die vor dem Internet kompetent waren, waren es danach meistens immer noch. Die Menschen, die vorher vor sich hin dümpelten, dümpelten weiter - nur mit besserer Grafik.
Niemand hatte damit gerechnet, dass die Elastizität eines Tages aufgebraucht sein würde
Fünfzehn Jahre lang war "die Cloud ist unendlich" die zuverlässigste Lüge der Unternehmens-IT. Keine böswillige Lüge. Eine nützliche. Sie erlaubte Architekten, für Spitzenlast zu entwerfen, ohne Kapazitäten zu planen. Sie erlaubte CFOs, Rechenleistung als Betriebskosten zu verbuchen. Und sie erlaubte mir, Kunden mit ernster Miene zu sagen: "Skalieren Sie einfach horizontal."
Dann begannen Kunden in Nordamerika und Großbritannien, Tickets zu schreiben, die klangen wie aus dem Jahr 2004. "Kann nicht provisionieren.""Kann nicht umplanen.""Versuchen Sie eine andere Region." Bei allen drei Hyperscalern, in bestimmten Regionen, bei bestimmten Instanzfamilien. AWS hat seinen eigenen Technikern Berichten zufolge aufgetragen, Rechenkapazität einzusparen "wo immer es geht" - interne Teams warten tagelang auf CPUs, weil Kundenworkloads Vorrang haben. Das ist die richtige Priorität. Es ist aber auch ein Satz, der in einem Geschäftsmodell nicht existieren sollte, dessen Versprechen "on demand" lautet.
Vor zehn Jahren hätte ich jeden ausgelacht, der das vorhergesagt hätte. Das gesamte Verkaufsargument war: Amazon, Google und Microsoft haben so viel überschüssiges Eisen, dass Ihr Workload ein Rundungsfehler ist. Und das stimmte auch. Sie haben den Rundungsfehler nur an Sprachmodelle verkauft.
Die Zahl, die es nicht geben dürfte
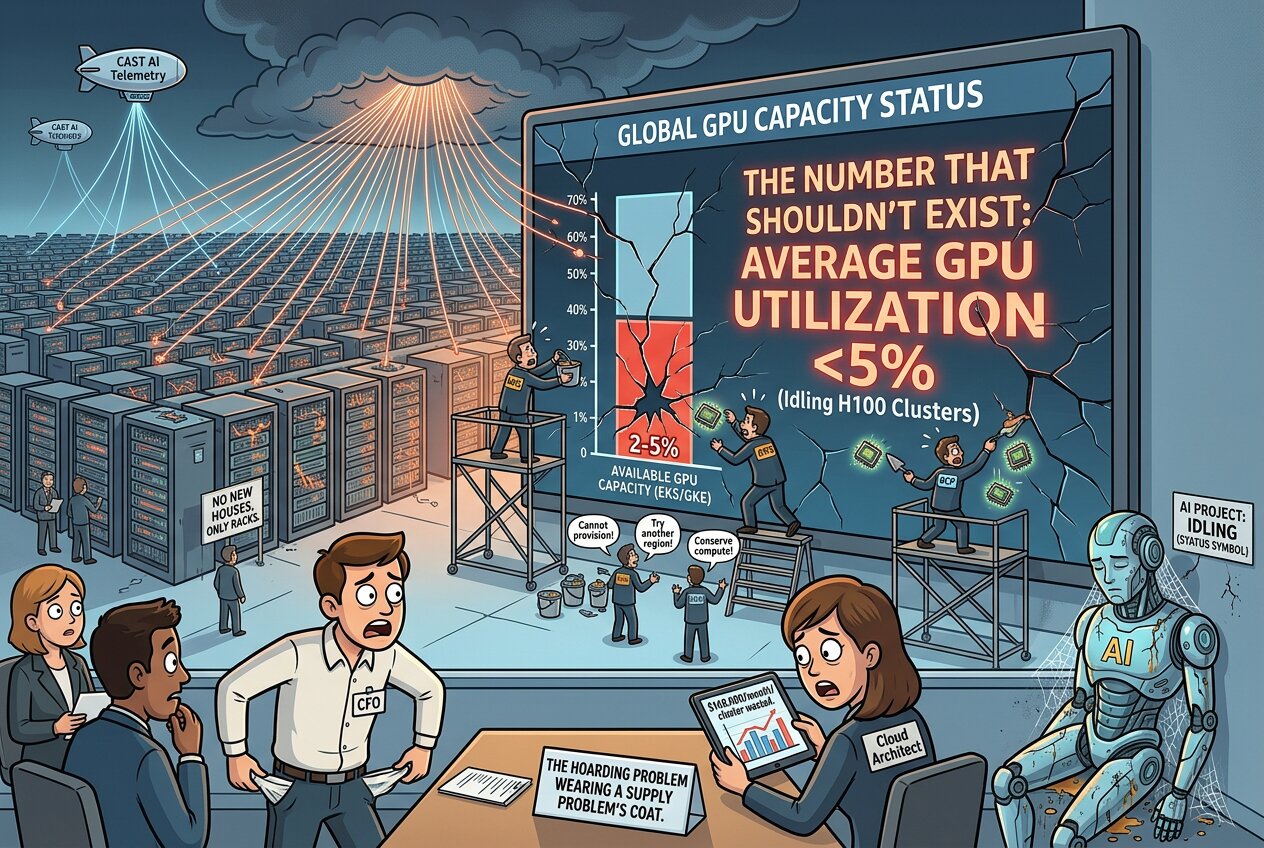
Jetzt kommt der Teil, bei dem es jedem Architekten mulmig werden sollte. Cast AI hat 2026 Telemetriedaten aus über 23.000 Produktionsclustern ausgewertet. Durchschnittliche GPU-Auslastung: rund 5%. Auf AKS: 2%. Auf EKS: 5%. Auf GKE: 6%.
Der schnellste Weg, sich komplett überflüssig zu machen
Es gibt einen neuen Jobtitel, auf den sich niemand beworben hat: biologischer Durchlauferhitzer (Englisch: "Meat Proxy"). Eine Person, die KI-generierten Text, Code oder Output weiterleitet, ohne ihn zu lesen, zu verstehen oder zu prüfen. Ein Relais. Ein USB-Kabel aus Fleisch und Blut zwischen einem Sprachmodell und einem Empfänger, der dasselbe Modell im Nebentab geöffnet hat.
Zum ersten Mal ist mir einer in den offenen Tickets aufgefallen. Kundeneskalation, Priorität hoch, wütend-aber-noch-höflich - die Art Problem, die Sie in zwanzig Minuten lösen, wenn Sie die Logs tatsächlich lesen. Die Antwort, die rausging, umfasste 900 Wörter in makelloser Struktur. Aufzählungszeichen. Eine Zusammenfassung. Ein Abschnitt "Nächste Schritte". Drei Vorschläge, alle technisch plausibel, keiner davon relevant - weil das Produkt sich seit zwei Hauptversionen nicht mehr so verhielt.
Die Antwort des Kunden war ein einziger Satz: "Hat das ein Mensch gelesen?"
Diese Frage ist das gesamte Problem. Sobald sie gestellt wird, erholen Sie sich davon nicht mehr vollständig. Denn der nächste Gedanke des Kunden ist der gefährliche: Wenn mir eine Maschine antwortet - warum bezahle ich dann für Sie?
Die Ökonomie ist brutal und einfach
Wert entsteht durch Knappheit. Text ist nicht mehr knapp. Text ist heute ein Gebrauchsgut wie Leitungswasser - und ungefähr genauso teuer.
Jobsicherheit durch unverzichtbaren Spaghetti-Code funktionierte prächtig - bis es das plötzlich nicht mehr tat.
Jede Technikabteilung hat so einen. Den Kollegen, dessen Code aussieht, als wäre er im Fiebertraum geschrieben worden - in einer Sprache, die er spontan erfunden hat. Keine Kommentare. Keine Dokumentation. Variablennamen wie xTmp_v2_FINAL_real. Funktionen, die sich über drei Dateien hinweg selbst aufrufen, ohne jeden erkennbaren Grund.
Und niemand fasst den Code an. Weil niemand ihn versteht. Und niemand versteht ihn, weil genau das der Zweck ist.
Ich habe mit einem Techniker gearbeitet - nennen wir ihn Gerald - der diese Kunst über fünf Jahre perfektioniert hatte. Fünf Jahre, in denen er systematisch eine Geiselnahme aufbaute, getarnt als Codebase. Jedes Modul unter seiner Verantwortung war ein vermintes Labyrinth. Neue Entwickler, die seinem Bereich zugewiesen wurden, hielten ungefähr zwei Sprints durch. Dann beantragten sie eine Versetzung, eine Therapie oder beides.
Das Management wusste, dass der Code schlecht war. Man konnte es riechen. Aber Gerald hatte sich zum einzigen Menschen gemacht, der sich durch das Labyrinth navigieren konnte - und die Geschäftslogik darunter war geschäftskritisch. Ein klassischer Single Point of Failure, eingewickelt in einen Single Point of Attitude.
Die implizite Drohung wurde nie laut ausgesprochen, aber jeder verstand sie: Kündigt mir, und dann viel Spaß mit den nächsten sechs Monaten voller Ausfälle.
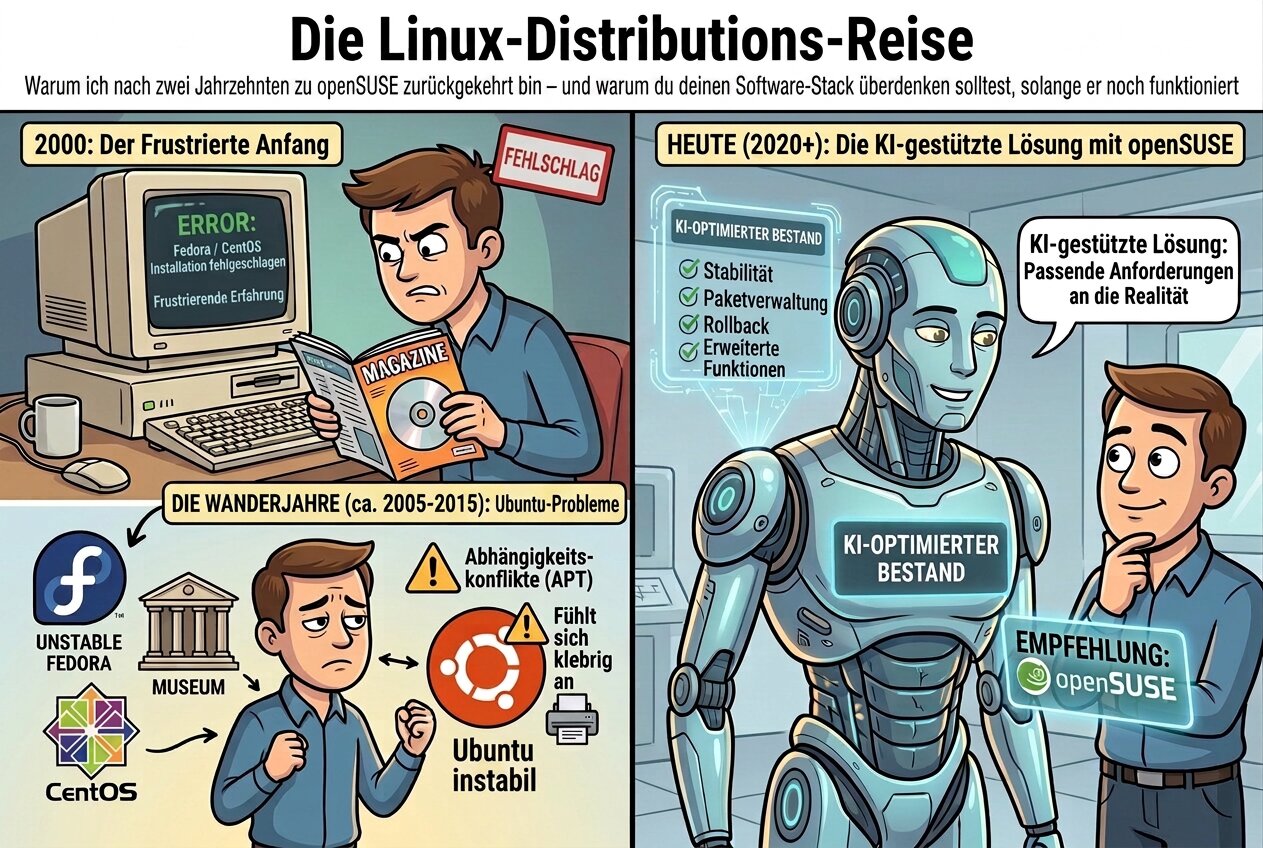
Warum ich nach zwei Jahrzehnten zu SUSE Linux zurückgekehrt bin - und warum Sie Ihren Stack überprüfen sollten, solange er noch funktioniert
Irgendwann um das Jahr 2000 herum kaufte ich eine Computerzeitschrift, weil eine CD auf dem Cover klebte. SUSE Linux 6.4. ReiserFS. Ich kam bis "Wählen Sie einen Einhängepunkt für root" und hörte auf - weil ich keine Ahnung hatte, was ein Einhängepunkt ist, und keine realistische Möglichkeit, es herauszufinden. Keine Suchmaschine in Reichweite. Kein Forum. Nur ich, ein beiger Tower und ein Dialogfenster, das mir eine Frage in einer Sprache stellte, die ich nicht beherrschte.
Ich brach die Installation ab. Mein erster Kontakt mit Linux endete mit Kapitulation am Partitionierungsbildschirm. Ich vermute, das ist die häufigste Entstehungsgeschichte unserer Branche.
Ein paar Monate später erschien SUSE 7 und ich bestellte die Schachtelversion. Sieben CDs. Ein gedrucktes Handbuch, dick genug, um ein kleines Geschoss aufzuhalten. Ein T-Shirt. Ein Chamäleon-Aufkleber. Und vor allem: kein Lizenzschlüssel, den irgendjemandes Cousin mit Edding auf eine Disc gekritzelt hatte. Ich installierte ein Betriebssystem, bei dem ich niemandem beweisen musste, dass ich es verdient hatte. Dieser Geruch von Freiheit hielt länger als das T-Shirt.
Dann kamen die Wanderjahre.
Fedora: elegant, modern und verlässlich kaputt im ungünstigsten Moment. CentOS: solide wie ein Tresor, mit einem Software-Repository, das sich anfühlte wie ein Museum mit Souvenirladen. Also tat ich, was alle taten, und sprang auf den Ubuntu-Zug auf. Und Ubuntu funktionierte. Meistens. Eine Zeitlang.
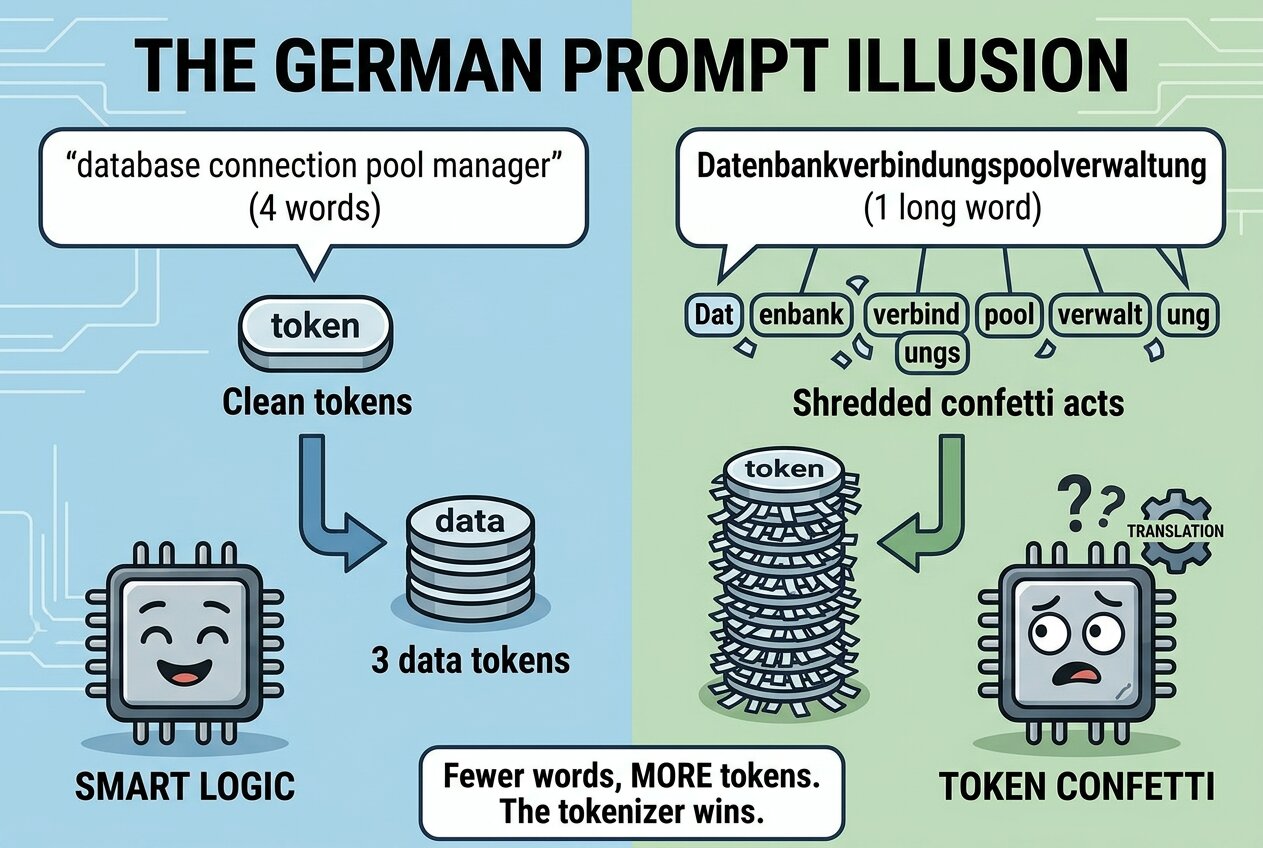
Deutsch ist objektiv eine dichtere Sprache als Englisch. Und das hat nichts mit Dichtern zu tun sondern mit dem Informationsgehalt pro Wort/Satz. Trotzdem macht es Ihre KI Prompts schlechter. Und der Grund verrät Ihnen ziemlich genau, wohin die Reise geht.
Vor einer Weile fragte mich jemand mit der aufrichtigen Begeisterung eines Menschen, der gerade eine große Idee hatte: "Deutsch ist doch so präzise. Wäre AI Prompting auf Deutsch nicht viel tokeneffizienter?"
Als Deutscher wollte ich das so sehr glauben. Endlich ein Wettbewerbsvorteil aus der Sprache, die der Welt Schadenfreude, Kummerspeck und Weltschmerz geschenkt hat.
Es stimmt nicht. Aber warum es nicht stimmt, ist interessanter als die Idee selbst.
Die deutsche Hypothese ist linguistisch stichhaltig
Deutsch packt tatsächlich mehr Bedeutung pro Wort. Komposita verschmelzen Konzepte zu eindeutigen Einheiten. Datenbankverbindungspoolverwaltung ist ein Wort, ein Konzept, und die Struktur verrät exakt, was wozu gehört. Das englische Pendant "database connection pool manager" besteht aus vier Wörtern und lässt offen, ob der Manager den Pool verwaltet, die Verbindungen oder die Datenbank. Dazu ein Kasussystem, das Beziehungen ohne Präpositionen codiert, und ein Wortschatz, der spezifische Begriffe vagen Oberbegriffen vorzieht. In der Theorie ergibt das weniger Wörter für dieselbe Anweisung.
Weniger Wörter, weniger Token, günstigere und schärfere Prompts. Wunderschöne Theorie.
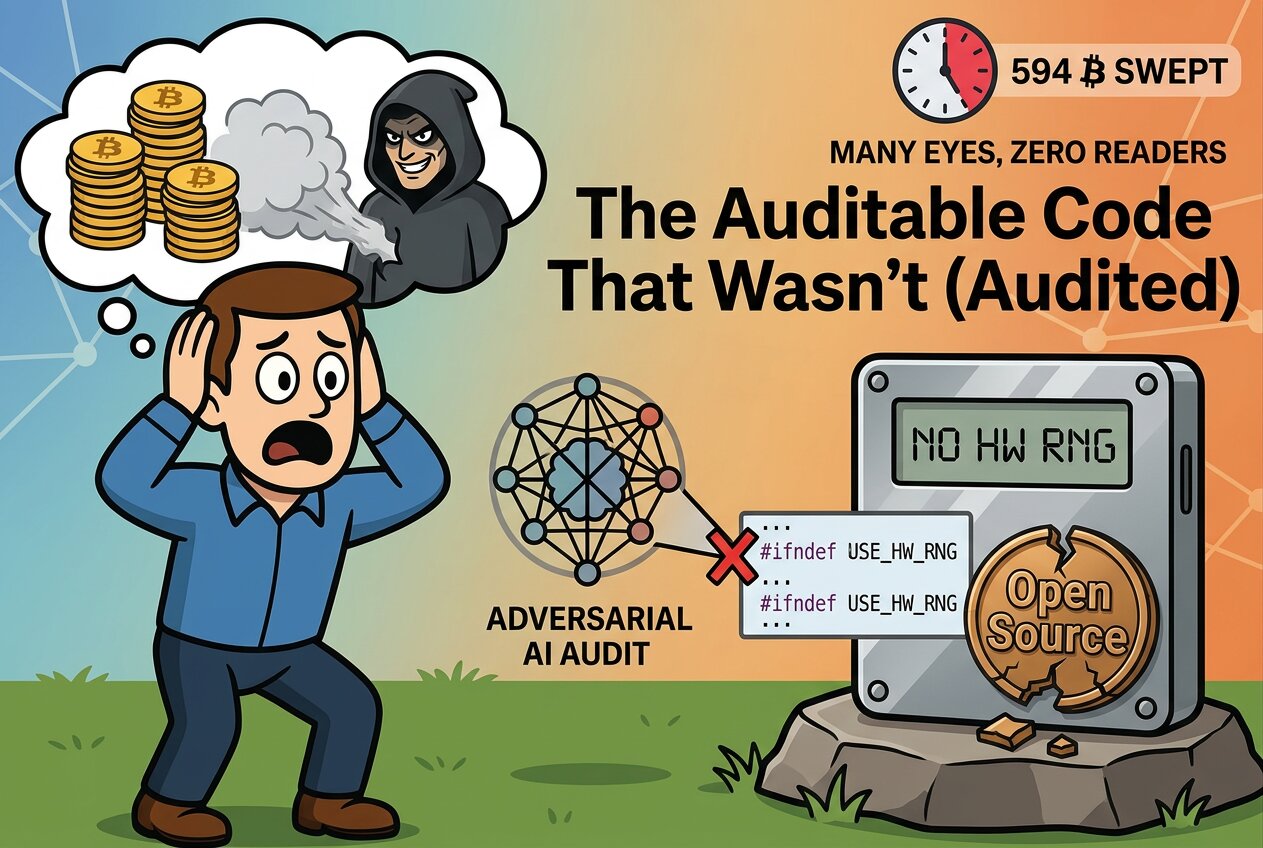
Eine Hardware-Wallet erzeugte Schlüssel mit einem Zufallsgenerator, den sie kein einziges Mal aufgerufen hat. Fünf Jahre lang. Der Quellcode war die ganze Zeit öffentlich zugänglich.
In einem Zeitfenster von 25 Minuten hat jemand rund 594 Bitcoin abgeräumt - etwa 38 Millionen Dollar - aus rund 500 voneinander unabhängigen Wallets. Kein Phishing. Keine Malware. Kein Angriff auf die Lieferkette. Kein 5-Dollar-Schraubenschlüssel.
Jede dieser Wallets war durch ein Gerät geschützt, das mit einem einzigen, bewundernswerten Versprechen verkauft wurde: Schlüssel offline erzeugt, auf isolierter Hardware, mit einem echten Hardware-Zufallsgenerator. Bitcoin-only, um die Angriffsfläche klein zu halten. Keine Cloud, keine Begleit-App, und Open-Source-Firmware, die Sie selbst überprüfen können.
Der Hardware-RNG saß auf der Platine. Unter Strom. Funktionsfähig.
Rund 1.900 Tage lang hat die Firmware ihn nicht ein einziges Mal nach einer Zahl gefragt.
Der Bug ist ein Zeichen lang.
Der Hersteller hat etwas völlig Vernünftiges getan: Er hat MicroPythons eingebauten Zufallspfad per Build-Flag abgeschaltet, weil er einen eigenen Wrapper um den echten RNG des Mikrocontrollers geschrieben hatte. Sauberes Embedded-Handwerk nach Lehrbuch.
Dann prüfte eine kryptografische Hilfsbibliothek dieses Flag mit #ifndef - was fragt: "Existiert dieses Makro?" Nicht: "Hat es einen Wert ungleich null?"
Das Makro existierte. Sein Wert war null. Also kam die Bibliothek zu dem Schluss, Hardware-Entropie sei verfügbar, und band sich fröhlich an MicroPythons Zufallsfunktion. MicroPython wiederum hatte dasselbe Makro korrekt gelesen und statt des Hardware-Peripheriegeräts einen nicht-kryptografischen Software-Fallback kompiliert.
 TrenchOps DE 🇩🇪🐎