 TrenchOps DE 🇩🇪🐎
Die Cloud ist voll
Niemand hatte damit gerechnet, dass die Elastizität eines Tages aufgebraucht sein würde
Fünfzehn Jahre lang war "die Cloud ist unendlich" die zuverlässigste Lüge der Unternehmens-IT. Keine böswillige Lüge. Eine nützliche. Sie erlaubte Architekten, für Spitzenlast zu entwerfen, ohne Kapazitäten zu planen. Sie erlaubte CFOs, Rechenleistung als Betriebskosten zu verbuchen. Und sie erlaubte mir, Kunden mit ernster Miene zu sagen: "Skalieren Sie einfach horizontal."
Dann begannen Kunden in Nordamerika und Großbritannien, Tickets zu schreiben, die klangen wie aus dem Jahr 2004. "Kann nicht provisionieren." "Kann nicht umplanen." "Versuchen Sie eine andere Region." Bei allen drei Hyperscalern, in bestimmten Regionen, bei bestimmten Instanzfamilien. AWS hat seinen eigenen Technikern Berichten zufolge aufgetragen, Rechenkapazität einzusparen "wo immer es geht" - interne Teams warten tagelang auf CPUs, weil Kundenworkloads Vorrang haben. Das ist die richtige Priorität. Es ist aber auch ein Satz, der in einem Geschäftsmodell nicht existieren sollte, dessen Versprechen "on demand" lautet.
Vor zehn Jahren hätte ich jeden ausgelacht, der das vorhergesagt hätte. Das gesamte Verkaufsargument war: Amazon, Google und Microsoft haben so viel überschüssiges Eisen, dass Ihr Workload ein Rundungsfehler ist. Und das stimmte auch. Sie haben den Rundungsfehler nur an Sprachmodelle verkauft.
Die Zahl, die es nicht geben dürfte
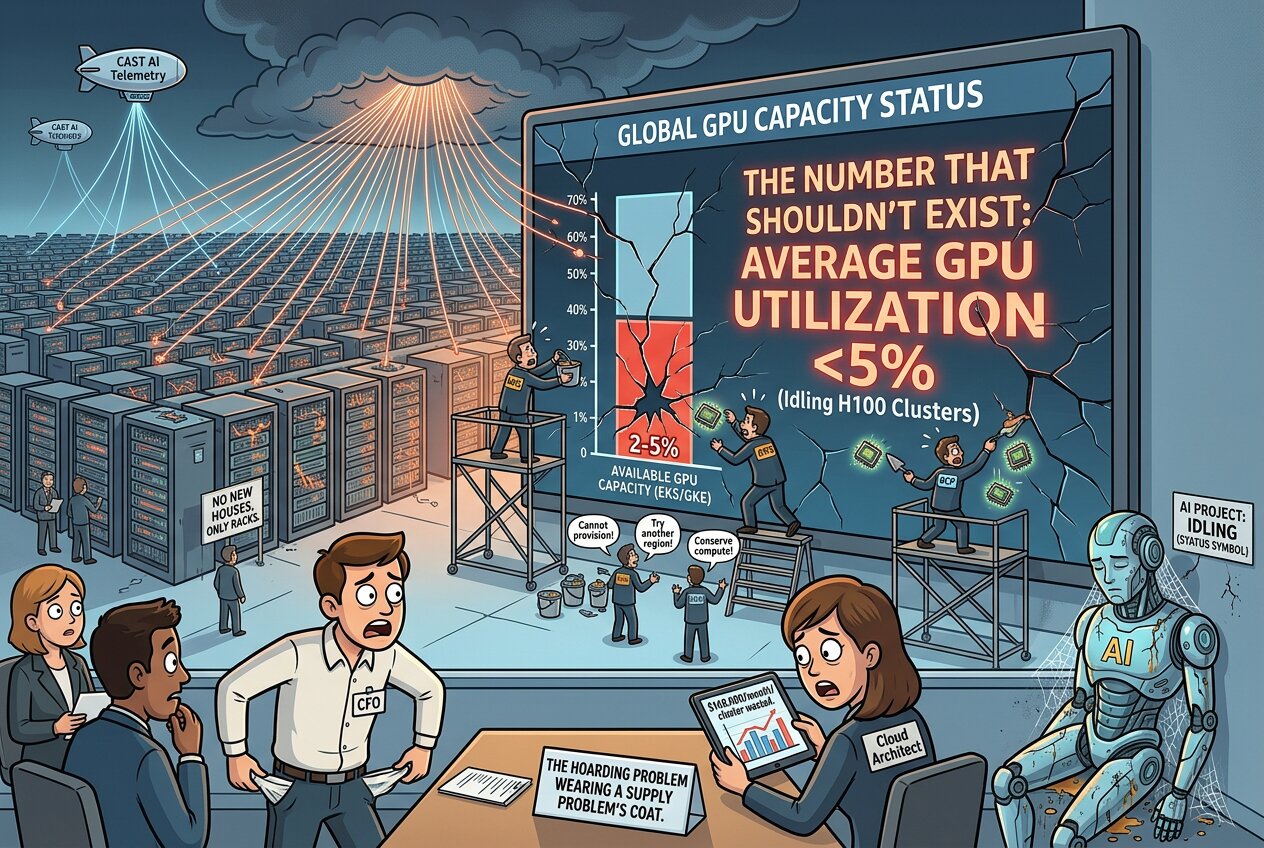
Jetzt kommt der Teil, bei dem es jedem Architekten mulmig werden sollte. Cast AI hat 2026 Telemetriedaten aus über 23.000 Produktionsclustern ausgewertet. Durchschnittliche GPU-Auslastung: rund 5%. Auf AKS: 2%. Auf EKS: 5%. Auf GKE: 6%.
Lesen Sie das noch einmal. Langsam. Und erinnern Sie sich dabei daran, dass die Hälfte der GPU-Cloud-Anbieter angeblich keine H100- und H200-Kapazitäten mehr hat, dass reservierte Kapazität sechs Monate im Voraus ausverkauft ist und dass AWS die Preise für ML Capacity Blocks angehoben hat - die erste GPU-Preiserhöhung in über einem Jahrzehnt Cloud-GPU-Verfügbarkeit.
Wir haben also einen globalen Engpass bei dem knappsten industriellen Rohstoff der Welt - und der durchschnittliche Käufer nutzt fünf Prozent dessen, was er gehortet hat.
Das ist kein Angebotsproblem. Das ist ein Hortungsproblem im Mantel eines Angebotsproblems. Ein 20-GPU-H100-Cluster, der bei dieser Auslastung vor sich hin döst, verbrennt rund 168.000 Dollar im Monat - für nichts. Multiplizieren Sie das über 23.000 Cluster, und Sie blicken auf den größten freiwilligen Transfer von Unternehmenswert in warme Luft in der Geschichte der Datenverarbeitung.
Nehmen Sie das Verhältnis zwischen dem, was Sie bezahlen, und den tatsächlichen Rechensekunden nützlicher Arbeit darin. Wenn dieses Verhältnis 20:1 erreicht, ist nicht der Input teuer. Dann ist Ihr Prozess kaputt. Niemandem in dieser Knappheit fehlen GPUs. Es fehlt an Scheduling-Disziplin. Und weil reservierte Kapazität inzwischen ein Statussymbol ist - Ihr Wettbewerber hat seinen Cluster angekündigt, also brauchen Sie auch einen - ist der Engpass teilweise von Leuten hergestellt, die wollen, was andere sichtbar wollen.
Die wirklich komische Konsequenz: Es ist durchaus möglich, dass ein erheblicher Teil des Kapazitätsengpasses, der Ihre Deployment-Pipeline abwürgt, von den GPUs anderer Unternehmen verursacht wird - GPUs, die bei 2% Auslastung im Leerlauf stehen, weil sie freizugeben wie ein Rückzug aussähe.
Warum der freie Markt das nicht einfach regelt
In einem Lehrbuchmarkt steigen die Preise, Kapazität folgt, die Kurve löst sich in ein, zwei Quartalen auf. Amazon hat Investitionen von rund 200 Milliarden Dollar angekündigt und ausdrücklich gesunkene Speicherpreise als Grund für die Erhöhung genannt. Google liegt bei insgesamt 600 Milliarden Dollar.
Und trotzdem sagen sie, es wird nicht reichen. Bis 2027. Mit zugesagter Nachfrage bis 2028.
Denn Geld kauft Silizium, und Silizium kauft nichts ohne drei Dinge, die Geld schlecht schnell beschaffen kann:
- Fabs und HBM. High-Bandwidth-Memory reagiert nicht auf eine Bestellung. Er reagiert auf mehrjährige Fab-Bauvorhaben, und die Lieferkette verläuft durch Regionen, die gerade ein Maß an geopolitischer Spannung genießen, für das kein Einkaufsteam einen Plan B hat. Speicher, GPUs und sogar Festplatten sind knapp. PC- und Smartphone-Absätze sinken, weil Hersteller keinen RAM bekommen. Ihr Laptop ist teurer, weil ein Chatbot ihn dringender brauchte.
- Land und Genehmigungen. Dieser Punkt ist der lehrreichste - und der am meisten ignorierte von Menschen, die ihr Berufsleben in Abstraktionen verbringen. Bitten Sie eine Gemeinde, ein Rechenzentrum aufzunehmen, und sie macht dieselbe Rechnung wie Sie. Was hat die Gemeinde davon? Einen Bauboom, dann eine Dauerbelegschaft, die in einen Kleinbus passt - ein paar Leute, die Dashboards beobachten, ab und zu eine Festplatte tauschen, und ein wirklich guter Klimatechniker. Was kostet es? Netzlast, Kühlwasser und steigende Strompreise. In Phoenix hat der größte Versorger eine Erhöhung von 14% für Privathaushalte und 45% für Großabnehmer beantragt - nach einem Rekordmonat, in dem rund die Hälfte des Wachstums auf Rechenzentren entfiel. Arizona hat Steuervorteile für neue Rechenzentren drei Jahre lang ausgesetzt. Etwa vierzig Städte haben sich einem Bündnis angeschlossen, das strengere Standards fordert.
Das ist kein "Nicht in meinem Hinterhof"-Reflex. Das ist ein rationaler Akteur, der ein Term Sheet liest, in dem er das gesamte Risiko trägt und nichts vom Gewinn hat. Risikoteilung funktioniert in beide Richtungen. Wenn Sie wollen, dass eine Gemeinde Ihre externen Kosten schluckt, müssen Sie ihr etwas Besseres bieten als Arbeitsplätze, die es nicht gibt. - Strom um drei Uhr nachts. Und hier wird es unangenehm. Wir haben mehr installierte Solar- und Windkapazität als je zuvor, und das Stromnetz bleibt trotzdem der Flaschenhals - weil ein Trainingslauf das Lastprofil einer Schmelzhütte hat, nicht das eines Haushalts. Flach, gewaltig, wetterfest. Fünfzehn Jahre Energiepolitik waren auf günstige Durchschnittskilowattstunden optimiert. KI braucht garantierte, abrufbare, unterbrechungsfreie Kapazität direkt neben einem Glasfaserknoten. Ein völlig anderes Produkt. Die Rechnung für diesen Mismatch kommt jetzt - aufgeschlüsselt auf der Stromrechnung privater Haushalte.
Kurzer Exkurs: die doppelten Maßstäbe
Ich bin alt genug, mich zu erinnern, als der Stromverbrauch von Bitcoin ein moralischer Notfall war. Leitartikel, ESG-Papiere, Grafiken mit fragwürdiger Arithmetik - "jede Transaktion bringt einen Swimmingpool zum Kochen."
Bitcoin verbraucht rund 150-175 TWh pro Jahr. Rechenzentren insgesamt liegen bei etwa 415 TWh, Tendenz steil steigend, wobei KI das am schnellsten wachsende Segment ist. KI spielt also in derselben Gewichtsklasse, nicht Größenordnungen darüber - und ein guter Teil der Ergebnisse sind Bilder von Katzen in Ritterrüstungen und LinkedIn-Posts, die Maschinen über die Bedeutung von Authentizität geschrieben haben.
Dagegen protestiert niemand. Nicht, weil sich die Zahlen geändert haben. Weil sich das Narrativ geändert hat. Energieverbrauch war nie der eigentliche Einwand. Es war Rhetorik im Gewand der Arithmetik. Und sobald der Konsument nicht mehr "Spekulant" hieß, sondern "Innovator", hörte die Arithmetik leise auf, eine Rolle zu spielen.
Ich sage das nicht, um das eine oder andere zu verteidigen. Ich sage es, weil Sie jeden Budget-Kampf verlieren werden, wenn Sie nicht erkennen, wann Ihnen jemand Rhetorik statt Messdaten unterjubelt - gegen jemanden, der das kann.
Was das am Montag für Sie bedeutet
👉 Ihr Data-Recovery-Plan enthält eine Fiktion. "Wir schwenken auf Region B um" setzt voraus, dass Region B Platz hat. Testen Sie es. Versuchen Sie tatsächlich, Ihr vollständiges Failover-Kontingent zu provisionieren. Manche von Ihnen werden feststellen, dass Ihr Business-Continuity-Plan ein Gedicht ist.
👉 Kapazitätsplanung ist wieder ein Job. Stellen Sie jemanden ein oder entwickeln Sie jemanden, der Bedarfsprognosen kann. Diese Fähigkeit wurde um 2014 für obsolet erklärt, und die Leute, die sie behalten haben, werden bald sehr gut bezahlt. Unterdessen sitzt das Zugpferd 🐎 in Ihrem Infrastruktur-Team, das seit zwei Jahren über brachliegende Reservierungen klagt, da und hat recht - unterbezahlt und ungelesen.
👉 Messen Sie die Auslastung, bevor Sie irgendetwas kaufen. Wenn Sie im Branchendurchschnitt liegen, können Sie Ihre effektive KI-Kapazität verfünffachen, ohne den Markt auch nur anzurühren. Das beste Bauteil ist kein Bauteil: Die günstigste GPU ist die, die Sie schon haben - und die wach ist.
👉 Reservieren Sie pessimistisch, entwickeln Sie optimistisch. Setzen Sie häufig Checkpoints. Machen Sie Jobs neustartbar und unterbrechungstolerant. Degradieren Sie elegant. Behandeln Sie Rechenleistung wie eine Spot-Ware - denn genau das ist sie geworden, während Sie an Ihrem Cloud-Strategiepapier geschrieben haben.
👉 Gehen Sie davon aus, dass die Knappheit mindestens bis 2027 der Normalzustand bleibt. Sowohl die Hyperscaler als auch JP Morgans Schätzung einer Angebotslücke von 15-30% sagen dasselbe. Planen Sie für Knappheit. Und falls der Überfluss zurückkehrt, genießen Sie die Überraschung.
Wir haben ein Jahrzehnt damit verbracht, einer Generation von Technikern beizubringen, dass Infrastruktur wie das Wetter ist - immer da, nie ihr Problem. Die Rechnung für diese Abstraktion kam als Provisionierungsfehler. Und es stellte sich heraus: Die Cloud war nie unendlich. Sie war nur - bis vor Kurzem - unterbelebt.
👇 Haben Sie tatsächlich schon versucht, Ihre vollständige Failover-Kapazität in Ihrer Ausweichregion zu provisionieren - oder ist das noch immer nur ein Diagramm?
0 comment(s)
No comments yet. Be the first to comment.
Leave a comment